
Marvell専門家による調査の要点:CPOが障害で延期、NPOが救済、注文は逆に2年後まで埋まる

NVIDIAの最大のライバルであるAMDが、MarvellのCPOソリューションを返品した――しかし、すぐに悲観する必要はない。なぜなら、顧客は「ダウングレード案」ですら待ちきれない状況で、Marvellの1.6T DSPのバックオーダーはすでに2年先まで埋まっているからだ。
(補足:調査専門家は顧客名を明かしていないが、Meta、OpenAIが最終的な買い手であり、MarvellがちょうどAMDのサプライチェーンを通じてこの2社に間接供給していることから、American Stock Investment Networkは、この顧客がほぼ間違いなくAMDだと推測している。)
この専門家調査の直感に反するところはここだ。悪いニュースはCPO技術が失敗したこと、良いニュースは需要があまりにも強く、誰も細かいことを気にしていないことだ。
このプロジェクトは元々、AMDがMetaやOpenAIのような大手バイヤー向けに用意したものである:6.4T帯域、32チャネルのCPO光インターコネクトソリューションで、MarvellのスイッチASICもパッケージ化されている。AMD自身は光学やスイッチチップの技術を持っていないため、サプライヤーはBroadcomかMarvellしか選べなかった。
結果、2026年初頭にサンプルが出たが、パフォーマンスが基準に達せず、歩留まりにも問題があった。そのためAMDは即座に決断し、NPO方式に切り替えた。
ここで重要なディテールがある。個人投資家は特に誤解しやすいが、出荷量予測は一切変更されておらず、変更されたのはデリバリー方式だけだ。顧客の裏にいるMetaやOpenAIが気にしているのは唯一つ——納期が守られることだけである。
CPOが理想の答えではあるが、NPOなら納品できるのであればそれを受け入れる。NPOは消費電力が高くコストも高い?AIインフラの構築が争いとなる時代、そんなことは問題にならない。
だから「CPO挫折」というタイトルに惑わされる必要はない。
専門家の原文は次の通りだ:
NPOは2~3年のライフサイクルを持つ過渡期製品にすぎず、2028年には市場需要が3,000万個に達する可能性がある——過渡期だけでもこんなに大きな市場になる。
CPOはなぜ失敗したのか?
理想的なCPOは、光学モジュールとGPUを一緒に封入するものである。しかし、現時点での現実は、MarvellやBroadcomの施策は「2社別々に部品を載せて同じ基板上にハンダ付け」という形にとどまっている。
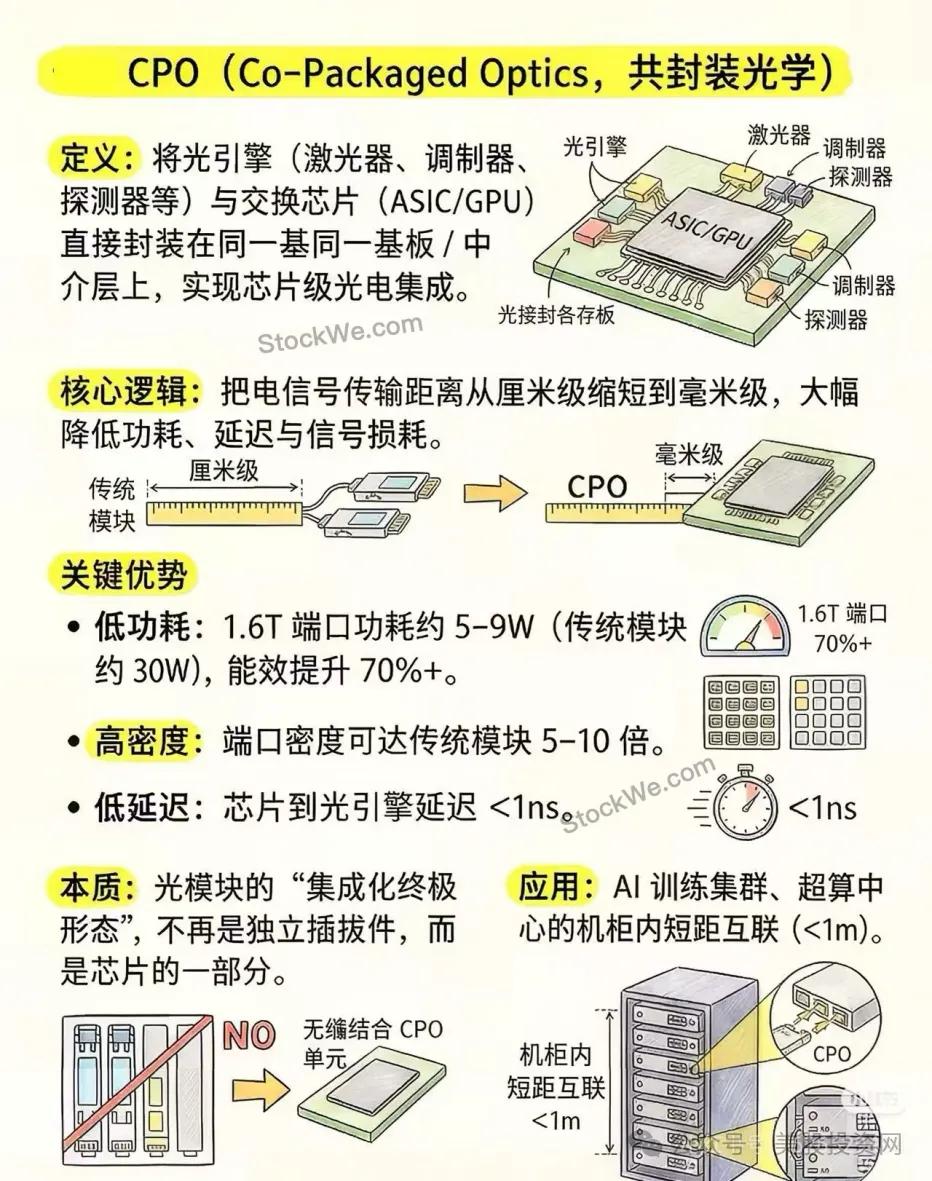
200Gの高速電気信号が何層もの基板やハンダ接点を通ることで損失が大きく、どれだけ修正してもうまくいかない。最後は信号整形用にリタイマー(簡易版DSP)を追加するしかなく、32チャネルに4つ加えるため、これらのチップと光エンジンを同一基板上に詰め込むこととなる。
この形態こそがNPOである。
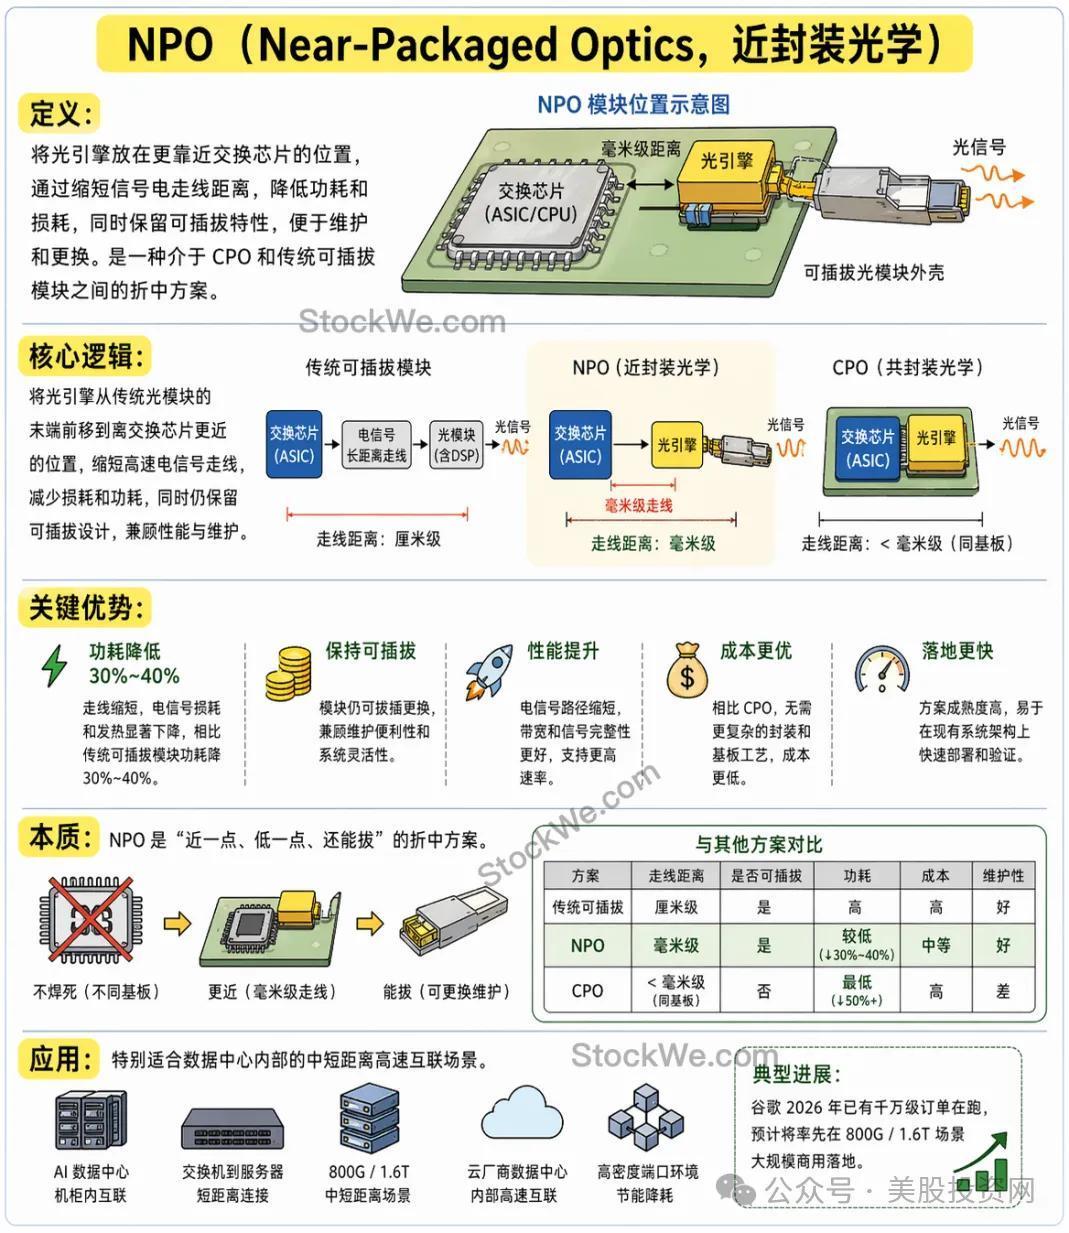
興味深いのは、これがMarvellだけの苦しみではないという点である。専門家は明言している:Broadcom、NVIDIA、AMD、Google、Amazon、業界全体が「路線があまりにもアグレッシブ」な罠にはまっている。NVIDIAはTSMCの真合封構造に賭けているが、歩留まりはさらに悪く、その構造ではDSPを組み込めないため、NPOに切り替えた後、この部分をAccelinkに外注したと言われている。
要するに、光インターコネクトは避けて通れない課題であり、CPOが一時的に実現できなければNPOで解決するしかない。ただしCPOを放棄しているわけではなく、各社とも両輪で開発を進めており、最終的なゴールはCPOである。
一通り整理してみれば、今のMarvellのポジションがいかに快適かがよくわかる。
Amazonは最も現実的な顧客である。Trainium 4(2027年下半期)は全面的に光インターコネクトに移行し、CPOが間に合わなければ即座にNPOに移行。Trainium 5のプロジェクトはすでに始まり、Marvellが買収したCelestial AIのソリューションが非常に好評である。
Googleは口では不要と言っても、実際は正直で、裏ではCPO/NPOのソリューションをずっと模索しており、Marvellにも相談したことがある。最近大きな契約を結んだのも、大きくはBroadcomやNVIDIAとのパワーバランス調整のためだ。理由は簡単だ:TPUは自社開発できても、光学は自社開発できず、この部分は買うしかない。
Microsoftは最も安定した基盤であり、ZRコヒーレント光モジュールの最大顧客で、次世代製品はほぼMarvellに決定している。うわさされている2027年末の数十万台規模のMicroLEDデバイス量産について、専門家の原文では「明確な納期スケジュールは『意外』、まだ初期研究段階が関の山」とされている。
OpenAIは400G PAM4という野心的なプロジェクトを持ちかけているが、専門家は2、3年以内は現実的ではないと見ている。なぜなら技術チェーン全体(TIA、Driver、SerDes)がまだ成熟していないからだ。
この調査でもっとも価値ある数字
1.6T DSP:バックオーダーは2年先まで。業界で噂の、今世代のDSPのあるチャネルに性能不足があり、リスピン(修正版)の開発中——これは事実だが、受注にはまったく影響がない;
ZRモジュール:月間出荷4~5万個、単価2,000~3,000米ドルで、収益は世界一。Googleはオープンオーダーで発注——800G ZRの標準に合致すれば、出荷分はいくらでも買う。現時点での問題は納品できないことであり、ボトルネックはサプライチェーン全体の生産能力にある;
中国企業数社:アセンブリ能力は世界トップレベルだが、DSP、TIA、Driverといった高収益のコアチップはほとんどMarvellから購入する必要がある。注文元はモジュールメーカーだが、利益の大半はチップメーカーに落ちる——これは国産光モジュール株への専門家による最も的確な注釈である。
リスクはどこにあるか?
公平な言い方をすれば、両面がある。
NPOは移行事業で2~3年のウィンドウしかなく、最終的にはCPOの戦いになる;
Broadcom、NVIDIA、COHR、さらにALAB(専門家の比喩:Broadcomは万能、Marvellは一回り小さいBroadcom、Asteraはさらに小さいMarvell)が大手顧客のすぐそばでポジション争いをしている;
あのシリコンバレー系スタートアップ群は、技術自体は難しくないが、TSMCのウェーハ生産能力を確保できず、それが致命傷になっている——大手顧客の後ろ盾無しには参入すらできない。
だから初めの結論に戻る:この調査が示しているのは技術失敗の話ではなく、「需要が大きすぎて許容範囲が広がっている」ストーリーだ。
光インターコネクトの分岐点はすでに過ぎており、今勝負しているのは方向性の正否ではなく、誰が納期通りに、安定して商品を納められるかである——そして、現段階で納品できないことこそが、業界全体の唯一共通の悩みなのだ。
米国株投資ネットVIP全面リニューアル
米国株ビッグデータ
米国株投資ネット
免責事項:本記事の内容はあくまでも筆者の意見を反映したものであり、いかなる立場においても当プラットフォームを代表するものではありません。また、本記事は投資判断の参考となることを目的としたものではありません。
こちらもいかがですか?
最新バージョン 3-Visaの業績が予想を上回る、堅実な消費者の継続的な支出による
Visa(V.US)の第4四半期収益は前年同期比13%増の121億ドル、越境決済取引額は14%増加
Visaの第4四半期の純収益は121億3900万ドルで、前年同期比13%増となりました。
「新しいFED通信社」:FRB高官の間で路線対立が勃発、ウォッシュの「沈黙戦略」はどこまで通用するのか?
「新しいFRB通信社」のNick Timiraos氏によると、FRB議長のウォッシュは「少ない発言」を重視する新たなコミュニケーション方針を推進しているが、多くの同僚から反発を受けている。2回の会合の間に、16人の当局者が計59回の公開発言を行い、それぞれ異なるシグナルを発信したため、市場の10月利上げ予想確率は70%から15%へと急落した。反対者は、方針について口を閉ざすことは憶測やノイズを助長するだけだと主張している。
Cerebrasが10%以上急騰!オラクルが初めてCerebrasとGoogleを導入すると発表し、NVIDIAとの協力を「マルチギガワット級」に拡大
OracleはCerebras AIチップの導入を発表し、2027年上半期に正式な展開を予定しています。Cerebrasに加え、OracleはNVIDIA、Google、Intelが支援するSambaNova Systemsを含む複数のチップメーカーとの提携契約も発表しました。NVIDIAとの協力において、Oracleは導入規模を「マルチギガワット級」まで拡大し、NVIDIAの最新世代「Vera Rubin」AIサーバーを採用する予定です。
暗号資産価格
もっと見る


